Las claves
- OpenAI habría alineado dos variantes bajo el nombre GPT-6, identificadas como Sol y Luna
- El movimiento llega poco después de que Anthropic colocara su Opus 5.5 en el centro
- Ahora compiten por sostener varias versiones de un mismo modelo en paralelo
De lanzamientos sueltos a catálogos con apellido.
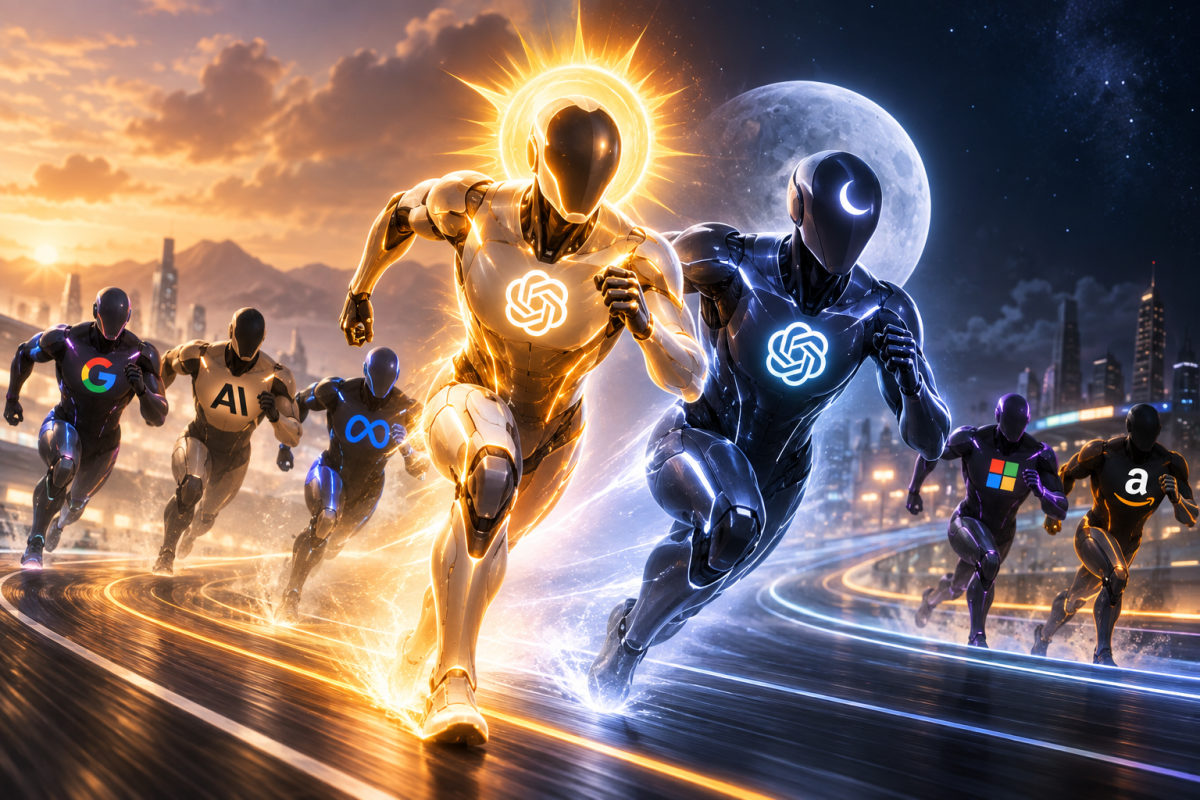
Durante años el sector funcionó con un ritual reconocible: una empresa presentaba un modelo, se comparaba con el anterior, la comunidad lo probaba unas semanas y el foco pasaba al siguiente anuncio. Ese ciclo se ha roto. Lo que hay sobre la mesa ahora no es un modelo suelto, sino una estrategia de catálogo. OpenAI habría alineado dos variantes bajo el nombre GPT-6, identificadas como Sol y Luna, y el movimiento llega poco después de que Anthropic colocara su Opus 5.5 en el centro de la conversación.
La diferencia no es cosmética. Antes competían por hitos aislados: quién sacaba antes una capacidad concreta, quién ganaba una comparativa puntual. Ahora compiten por sostener varias versiones de un mismo modelo en paralelo, con ritmos de actualización distintos y públicos distintos. Es una carrera de relevos encadenados, no de una sola vuelta.
Conviene separar lo confirmado de lo que circula. OpenAI no ha publicado una ficha técnica completa de esa familia, y Anthropic tampoco ha detallado todas las variantes que acompañan a Opus 5.5. La estructura de nombres es la parte visible; el resto se irá concretando.
Qué significa que un mismo modelo tenga dos apellidos.
Nombrar dos versiones bajo un mismo paraguas responde a una idea que ya venía gestándose: segmentar por tipo de uso en lugar de por generación. Una variante tiende a priorizar razonamiento y precisión, con respuestas más pausadas y coste por consulta más alto. La otra suele orientarse a velocidad y volumen, para tareas donde hace falta respuesta inmediata sin pagar el precio del razonamiento profundo.
Históricamente esa distinción se resolvía con modelos distintos y nombres distintos, lo que obligaba al usuario a entender la nomenclatura de cada proveedor. Agruparlos bajo un solo nombre simplifica la comunicación comercial y, de paso, evita que quien elige la variante rápida sienta que se queda con la versión barata de una generación vieja.
Por dentro, la diferencia entre estas variantes acostumbra a estar en el entrenamiento y en la configuración de inferencia: cuánto tiempo dedica el modelo a razonar antes de responder, cuántos recursos se asignan por consulta y qué mecanismos de control se aplican. No son dos modelos independientes con arquitecturas distintas, sino dos perfiles de comportamiento sobre una base común. Eso explica que compartan nombre y que la elección dependa del caso de uso.
Qué cambia para quien usa estas herramientas.
Para quien trabaja a diario con asistentes de texto, el efecto más visible es que la elección deja de ser binaria. Ya no se trata de usar el mejor modelo disponible, sino de decidir qué perfil encaja con cada tarea. Eso introduce una capa de gestión que antes no existía:
- Probar cada variante con las tareas reales del equipo, no con ejemplos genéricos.
- Fijar un modelo por flujo de trabajo y documentar por qué se eligió.
- Revisar esa decisión cuando aparece una versión nueva o cambia el precio.
- Medir latencia y coste por consulta, no solo calidad de respuesta.
- Definir quién puede cambiar la configuración sin romper integraciones.
En la práctica, ese trabajo es mayor de lo que parece y explica por qué muchos equipos acaban estandarizando un único modelo por comodidad, aunque no sea el óptimo para todo. Lo que sigue igual es la dependencia del proveedor: cambiar de familia no es trivial cuando ya hay integraciones, prompts afinados y datos de uso acumulados.
La compatibilidad también pesa. Cambiar de variante dentro de la misma familia suele ser barato porque la interfaz de programación se mantiene. Cambiar de proveedor es otra historia: obliga a revisar formatos de mensaje, herramientas conectadas, gestión de contexto largo y comportamiento ante instrucciones complejas.
La elección ya no es qué modelo es mejor, sino qué perfil encaja con cada tarea.
En ByteHoy | Claude ya lidera el 26% del trabajo de investigación y desarrollo de Anthropic
Cómo se reparte el trabajo entre variantes.
La asignación entre Sol y Luna no está documentada de forma pública. En familias con este planteamiento, la lógica habitual es que el enrutado se decida por la naturaleza de la petición: consultas simples van a la variante rápida, tareas que requieren varios pasos o razonamiento encadenado van a la variante lenta. Cuando la petición no encaja limpiamente en ninguno de los dos perfiles, entran reglas internas que el usuario no ve y que pueden cambiar sin aviso.
| Opción | Perfil | Uso típico | Coste por consulta |
|---|---|---|---|
| GPT-6 Sol | Razonamiento y precisión | Análisis, código complejo, tareas largas | Más alto |
| GPT-6 Luna | Velocidad y volumen | Respuestas inmediatas, clasificación, resúmenes | Más bajo |
| Opus 5.5 | Gama alta de Anthropic | Trabajo con contexto extenso y precisión | Sin dato público |
| Modelos abiertos | Control y despliegue propio | Entornos con requisitos de soberanía o coste fijo | Según infraestructura |
La tabla refleja el planteamiento declarado, no cifras oficiales. Ni OpenAI ni Anthropic han publicado tarifas cerradas para estas variantes, y el coste real depende del volumen, del proveedor de nube y de la longitud de contexto.
Límites conocidos y problemas reales.
Los nombres y la estructura de la familia son la parte fácil de comunicar. Lo que sigue sin resolverse son los detalles que deciden si el planteamiento funciona a escala:
- Precio por variante: no hay tarifa oficial publicada.
- Límites de contexto: no se ha detallado cuánto contexto admite cada perfil.
- Disponibilidad regional: sin fecha ni lista de países confirmada.
- Comportamiento en tareas largas: es donde se rompen muchas promesas.
- Enrutado automático: no se sabe con qué criterios se decide entre variantes.
A eso se suma un problema de método. Cualquier comparativa entre estas variantes caduca rápido porque los pesos y la configuración cambian sin anuncio. Medir hoy y decidir dentro de tres meses con esos datos es un error habitual.
Alternativas y competencia directa.
Con Anthropic y OpenAI empujando en paralelo, el resto queda en posición incómoda. Los modelos abiertos mantienen su hueco donde el control y el coste pesan más que el rendimiento puntero, pero la brecha en tareas complejas tiende a ensancharse.
Para las empresas que construyen producto sobre estas interfaces, el problema no es la falta de opciones, sino la velocidad a la que caducan. Abstraer la capa de acceso y no casarse con un proveedor suena bien sobre el papel y cuesta bastante llevarlo a la práctica, sobre todo cuando las herramientas de cada proveedor tienen particularidades que no se replican en otros.
La diferencia real entre familias no está en la lista de capacidades, que tiende a converger, sino en cómo se comporta cada una ante instrucciones ambiguas y contexto extenso. En ese terreno, el trabajo con modelos de lenguaje sigue dependiendo de pruebas propias más que de comparativas ajenas.
Qué falta por saber.
Los precios reales de cada variante, los límites de uso, la disponibilidad por regiones y el comportamiento en tareas largas siguen sin confirmarse. Tampoco está definido cómo se repartirá el trabajo entre Sol y Luna cuando la petición no encaje en ninguno de los dos perfiles.
Hasta que eso se estabilice, cualquier comparativa es provisional. Lo sensato es medir en el propio caso de uso antes de mover nada, y asumir que la decisión de hoy puede dejar de ser válida en pocos meses.
En ByteHoy | EE. UU. propone a China un sistema de alerta para incidentes graves relacionados con la inteligencia artificial
Comentarios
Sé el primero en comentar esta noticia.